TL;DR
- Wat: Onderzoekers hebben een methode ontwikkeld (Repo-To-Skill) die kennis uit GitHub-repositories omzet in compacte, herbruikbare "skills" voor AI-agents.
- Waarom relevant: AI-agents die taken uitvoeren worden steeds gangbaarder in het MKB — hoe sneller en betrouwbaarder die agents werken, hoe lager de kosten.
- Wat je ermee kunt: Houd in de gaten hoe AI-agents in jouw softwaretools slimmer worden door voorgebakken kennis — dat beïnvloedt wat je kunt automatiseren en tegen welke prijs.
Ik stuitte op een paper die afgelopen week op arXiv verscheen: Repo-To-Skill. De titel klinkt technisch, maar de kern is verrassend logisch. Onderzoekers hebben een manier gevonden om de praktische kennis die in duizenden open-source softwareprojecten zit, samen te persen tot hapklare instructies waar AI-agents direct mee aan de slag kunnen. Ik vind het een interessant signaal voor hoe AI-tools zich de komende tijd gaan ontwikkelen.
Wat is het probleem dat dit oplost?
Stel je voor: je hebt een AI-agent die zelfstandig een technische taak moet uitvoeren. Denk aan het bouwen van een voorspelmodel, het analyseren van data, of het schrijven van een stuk code. Die agent heeft toegang tot een slim taalmodel — zeg GPT-5.5 — en een set gereedschappen om te plannen en uit te voeren.
Maar hier zit het pijnpunt: de agent mist operationele kennis. Dat is het verschil tussen weten dát een methode bestaat en weten hoe je 'm werkend krijgt. Welke configuratie werkt het beste? Welke valkuilen zijn er? Welke volgorde van stappen levert het gewenste resultaat?
Die kennis zit verspreid over GitHub-repositories, wetenschappelijke papers en documentatie — geschreven voor mensen, niet voor AI. Het gevolg: de agent moet bij elke taak opnieuw het wiel uitvinden. Dat kost rekenkracht, tijd en geld.
Wat mij hier opvalt: dit is eigenlijk hetzelfde probleem dat je als ondernemer herkent als je een nieuwe medewerker inwerkt. Die persoon kan slim zijn, maar zonder de praktijkkennis van jouw bedrijf begint diegene elke dag opnieuw. Een goed inwerkprogramma bespaart maanden aan trial-and-error.
Hoe werkt Repo-To-Skill?
De onderzoekers — verbonden aan onder meer de Beijing Academy of Artificial Intelligence en de Hong Kong Polytechnic University — introduceren een agent genaamd DisCo. Die doet twee dingen:
Kennis destilleren uit repositories
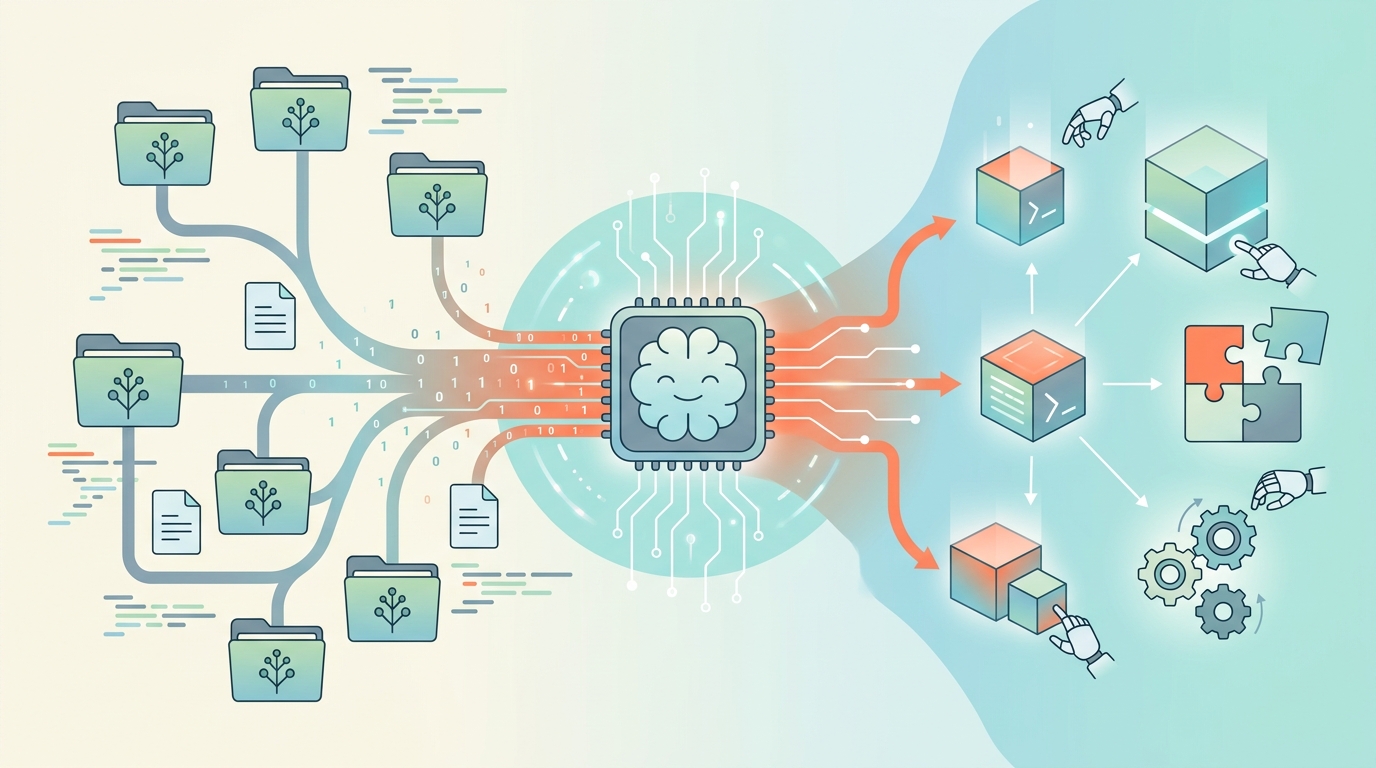
DisCo neemt bestaande, veelgebruikte open-source repositories en destilleert daar de essentiële kennis uit. Dat levert per repository een compacte "skill" op, opgebouwd uit drie lagen:
- Een kennisinterface (een beknopt SKILL.md-bestand dat de kern samenvat)
- Ondersteunende referenties (links naar relevante secties uit de originele code en papers)
- Uitvoerbare scripts (zodat de agent de kennis direct kan toepassen)
Dit proces kent twee varianten: task-agnostic (repositories vooraf omzetten, ongeacht de specifieke taak) en task-oriented (skills on-demand maken voor een concreet probleem).
Een bibliotheek van 5.000+ skills
Het resultaat is de AREX-Skill Library: meer dan 5.000 geverifieerde skills, gedestilleerd uit 1.000 veelgebruikte machine-learning-repositories. Die zijn georganiseerd in 20 onderzoeksgebieden en 178 zogenoemde "capability families" — groepen van verwante vaardigheden.
Ik vind het eerlijk gezegd bijzonder dat je een bibliotheek van deze omvang kunt opbouwen uit bestaande open-source projecten. Het is alsof je alle praktijkhandboeken van een vakgebied comprimeert tot een naslagwerk dat een machine kan lezen.
De resultaten: flink verschil
De onderzoekers hebben getest wat er gebeurt als je dezelfde AI-agent (GPT-5.5 als ruggengraat) dezelfde taken laat uitvoeren — één keer mét skills, één keer zonder. De budgetten voor rekenkracht bleven gelijk.
De resultaten op vier benchmarks:
- MLE-bench (machine learning engineering): +134,3%
- PaperBench (wetenschappelijk onderzoek nabootsen): +34,4%
- FrontierCS (geavanceerde taken): +9,2%
- PassNet: +14,0%
Die 134,3% op MLE-bench springt eruit. Dat betekent dat dezelfde agent, met dezelfde rekenkracht, meer dan twee keer zo goed presteert als die vooraf "ingewerkt" is met relevante skills.
Nu wil ik hier wel een kanttekening bij plaatsen: dit zijn resultaten op specifieke benchmarks in een onderzoeksomgeving. Hoe dit zich vertaalt naar dagelijkse bedrijfstoepassingen is nog een open vraag. Maar de richting is duidelijk.
Wat betekent dit voor ondernemers?
Je denkt misschien: leuk dat AI-onderzoekers hun agents beter maken, maar wat heb ik daaraan?
Ik denk dat het antwoord zit in een bredere trend. Volgens recente cijfers verwacht Gartner dat tegen eind 2026 zo'n 40% van alle bedrijfssoftware een vorm van AI-agents bevat. In Nederland gebruikt op dit moment 28% van de bedrijven met minder dan 50 medewerkers AI structureel — bij middelgrote bedrijven is dat 42%.
De AI-agents die jij straks in je boekhoudsoftware, CRM of projectmanagementtool tegenkomt, worden gebouwd op dezelfde principes als DisCo. Hoe beter die agents vooraf zijn uitgerust met relevante kennis, hoe minder rekentijd ze nodig hebben, hoe sneller ze werken, en hoe lager de kosten.
Kun je je voorstellen wat het betekent als een AI-agent die jouw data-analyse doet niet elke keer opnieuw hoeft uit te zoeken hoe een bepaalde techniek werkt? Dat is het verschil tussen een stagiair op dag één en een ervaren medewerker.
De kostenkant
Wat mij betreft is het kostenaspect het meest concrete. AI-agents verbruiken rekenkracht. Elke keer dat een agent moet experimenteren — proberen, falen, opnieuw proberen — kost dat geld. Skills die vooraf zijn gedestilleerd, verminderen dat trial-and-error-proces. Voor een MKB-ondernemer die AI-tools inzet, betekent dat: betere resultaten voor hetzelfde budget, of dezelfde resultaten voor minder geld.
Open source als kennisbron
Een ander punt dat ik interessant vind: de skills zijn gedestilleerd uit open-source repositories. Dat betekent dat de collectieve kennis van duizenden ontwikkelaars wereldwijd wordt hergebruikt. Voor kleinere bedrijven die geen eigen AI-team hebben, is dit relevant — de tools die je gebruikt profiteren indirect van dezelfde kennisbasis als de grote techbedrijven.
Waar past dit in het grotere plaatje?
Repo-To-Skill past in een ontwikkeling die ik al langer volg: AI-systemen verschuiven van praten naar doen. Een taalmodel dat tekst genereert is stap één. Een agent die zelfstandig taken uitvoert is stap twee. En een agent die dat doet met voorgebakken vakkennis — zonder elke keer opnieuw te moeten leren — is een logische maar belangrijke stap drie.
Ik zou zelf willen weten hoe snel dit soort skill-bibliotheken beschikbaar komt in commerciële tools. De AREX-Skill Library is nu gericht op machine learning, maar het principe — kennis uit bestaande bronnen destilleren tot herbruikbare instructies — is breder toepasbaar. Denk aan boekhouding, logistiek, klantenservice.
Voor mij is dit vooral een signaal dat de AI-agents die we de komende jaren in bedrijfssoftware gaan zien, niet alleen slimmer worden door betere modellen, maar ook door betere voorbereiding. En dat is uiteindelijk goed nieuws voor ondernemers die willen dat AI daadwerkelijk werk uit handen neemt — zonder eindeloos te moeten experimenteren.
80% van de AI-projecten haalt productie nooit.
Ik bouw de 20% — van prototype naar draaiend systeem, binnen weken.