TL;DR
- Wat: Bittensor heeft Teutonic-II-110B gelanceerd op Subnet 3 — een taalmodel met 110 miljard parameters, getraind door een open netwerk van deelnemers in plaats van één techbedrijf.
- Waarom relevant: als grote AI-modellen niet langer alleen van Big Tech hoeven te komen, kan dat op termijn meer concurrentie en lagere kosten betekenen voor bedrijven die AI willen inzetten.
- Wat je ermee kunt: houd in de gaten of decentraal getrainde modellen in kwaliteit dichtbij komen — dat bepaalt of ze een realistisch alternatief worden voor je huidige AI-leverancier.
Ik stuitte op een tweet van gebruiker @2xnmore die stelt dat de oprichter van Bittensor is gestopt met alleen praten over decentrale AI en nu zelf een groot model aan het trainen is. Teutonic-II-110B heet het, en het draait op Subnet 3 van het Bittensor-netwerk. Ik vond dat het uitzoeken waard, want de belofte van AI-training buiten Big Tech om is iets waar ik al een tijdje op let.
Wat is Bittensor eigenlijk?
Bittensor is een open-source protocol dat blockchain-technologie gebruikt om een decentraal netwerk voor machine learning op te zetten. Het werd in 2019 opgericht door Jacob Steeves en Ala Shaabana. Het basisidee: in plaats van dat één bedrijf als Google of OpenAI een model traint op eigen servers, doen onafhankelijke deelnemers — zogenaamde miners — dat samen via het internet.
Die miners worden beloond in TAO, de cryptomunt van het netwerk, op basis van hoe waardevol hun bijdrage is aan het collectieve model. Denk aan het als een soort marktplaats: wie de beste verbetering levert aan het model, verdient het meest.
Het netwerk is opgedeeld in subnets, elk met een eigen focus. Subnet 3 richt zich specifiek op het trainen van grote taalmodellen — het soort AI dat achter tools als ChatGPT zit.
Van 72B naar 110B: de stappen tot nu toe
Om Teutonic-II in perspectief te plaatsen: eerder dit jaar voltooide Subnet 3 onder de naam Templar al Covenant-72B, een model met 72 miljard parameters. Dat werd getraind op circa 1,1 biljoen tokens — volledig op reguliere hardware verspreid over het internet. Volgens Bittensor was de prestatie vergelijkbaar met Meta's LLaMA-2-70B.
Daarna kwam Teutonic-LXXX, een model van 80 miljard parameters, aangekondigd op 11 mei 2026. Dat werd al omschreven als de grootste decentrale trainingsrun ooit.
Nu is Teutonic-II-110B live. Volgens de brontweet gaat het om 110 miljard parameters, tien keer groter dan een eerder model van het team en vijftig procent groter dan welke decentrale trainingsrun dan ook. Die claim van "tien keer groter" kan verwijzen naar een kleiner model dat aan Teutonic-II voorafging — de precieze referentie wordt in de tweet niet gespecificeerd.
Wat ik ook opvallend vind: Teutonic-II maakt volgens beschikbare informatie gebruik van een sparse Mixture-of-Experts-architectuur. Dat is een techniek waarbij niet alle 110 miljard parameters tegelijk actief zijn. Vergelijk het met een bedrijf met 110 specialisten: bij elke vraag worden alleen de relevante experts ingeschakeld, niet het hele team. Dat maakt het model efficiënter in gebruik dan een traditioneel model van dezelfde omvang.
Hoe werkt die training zonder centraal datacenter?
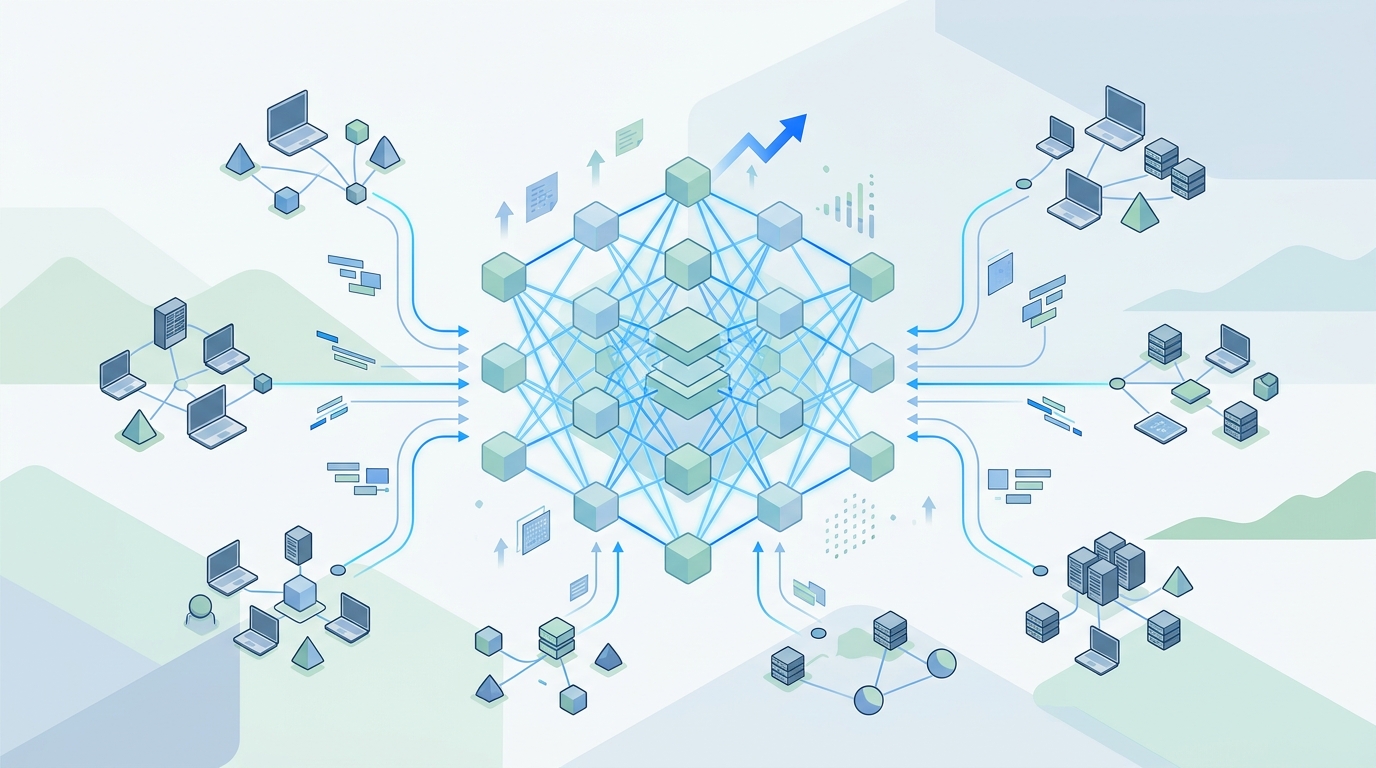
Dit is het deel dat mij het meest fascineert. Het systeem werkt als een doorlopende competitie — een king-of-the-hill-mechanisme:
- Er is een huidig leidend model, de "KING".
- Miners klonen dat model en trainen er zelfstandig verbeteringen op, met hun eigen hardware.
- Validators beoordelen de inzendingen aan de hand van een apart evaluatiedataset (Hippius genaamd).
- Als een inzending beter presteert dan de huidige KING, wordt die de nieuwe standaard.
- De winnende miner verdient beloningen tot iemand anders het beter doet.
Het bijzondere is dat deelnemers verschillende hardware en trainingsmethoden mogen gebruiken. Dat stimuleert innovatie in optimalisatietechnieken. Het is geen centraal aangestuurd project — iedereen met voldoende GPU-rekenkracht kan meedoen of stoppen wanneer die wil.
Wat betekent dit voor ondernemers?
Laat ik eerlijk zijn: voor de gemiddelde MKB-ondernemer is Teutonic-II-110B vandaag nog geen product dat je morgen inzet. Maar er zitten een paar ontwikkelingen in die ik de moeite waard vind om te volgen.
Concurrentie voor de grote AI-aanbieders
Als het technisch haalbaar blijkt om modellen van deze omvang decentraal te trainen met vergelijkbare kwaliteit, dan hoef je als bedrijf niet langer uitsluitend te leunen op OpenAI, Google of Anthropic. Meer aanbod betekent in principe meer keuze en op termijn mogelijk lagere prijzen. Kun je je voorstellen wat dat betekent als je maandelijks honderden euro's aan API-kosten betaalt?
Minder afhankelijkheid van één leverancier
Een terugkerend thema dat ik zie in analyses over decentrale AI is vendor lock-in. Als je al je processen hebt ingericht op één AI-aanbieder en die verandert de prijzen of voorwaarden, zit je vast. Open modellen — zeker als ze kwalitatief meekomen — geven je een alternatief. Dat is geen reden om morgen over te stappen, maar wel om je opties open te houden.
De kanttekening: kwaliteit moet zich nog bewijzen
Ik wil hier wel bij zeggen dat "110 miljard parameters" niet automatisch "beter" betekent. Parameteraantal is één ding, maar de kwaliteit van de trainingsdata, de architectuur en de fine-tuning bepalen uiteindelijk hoe bruikbaar een model is. Het eerdere Covenant-72B zou vergelijkbaar presteren met Meta's LLaMA-2-70B — dat is prima, maar niet per se beter dan wat je nu van de grote spelers krijgt. Het is dus afwachten hoe Teutonic-II-110B zich in benchmarks gaat meten.
Een breder signaal
Wat mij hier opvalt, los van de technische details, is de richting. Tot voor kort was het trainen van een groot taalmodel iets waarvoor je een datacenter nodig had van honderden miljoenen euro's. Dat een open netwerk van losse deelnemers nu modellen van deze schaal kan produceren — zelfs als de kwaliteit nog moet worden bewezen — vind ik een opmerkelijke verschuiving.
Ik denk dat het voor ondernemers niet zozeer gaat om Bittensor specifiek, maar om wat het laat zien: de toegang tot AI-ontwikkeling wordt breder. Dat is een trend die ik de komende maanden in de gaten blijf houden. Voor mij is dit vooral een signaal dat de markt voor AI-modellen minder gesloten wordt dan veel mensen denken — en dat is, wat mij betreft, relevant voor iedereen die zakelijk op AI leunt.
80% van de AI-projecten haalt productie nooit.
Ik bouw de 20% — van prototype naar draaiend systeem, binnen weken.