TL;DR
- Wat: Een open-source LoRA-adapter voor Qwen-Image-2.1 genereert vanuit één productfoto dezelfde afbeelding vanuit 72 verschillende camerahoeken.
- Waarom relevant: Wie producten verkoopt online, betaalt nu vaak tientallen euro's per SKU voor meerdere fotohoeken — dit model biedt een gratis alternatief.
- Wat je ermee kunt: Bekijk of je huidige productfotografiekosten omlaag kunnen door één foto te laten omzetten naar meerdere hoeken met dit soort AI-modellen.
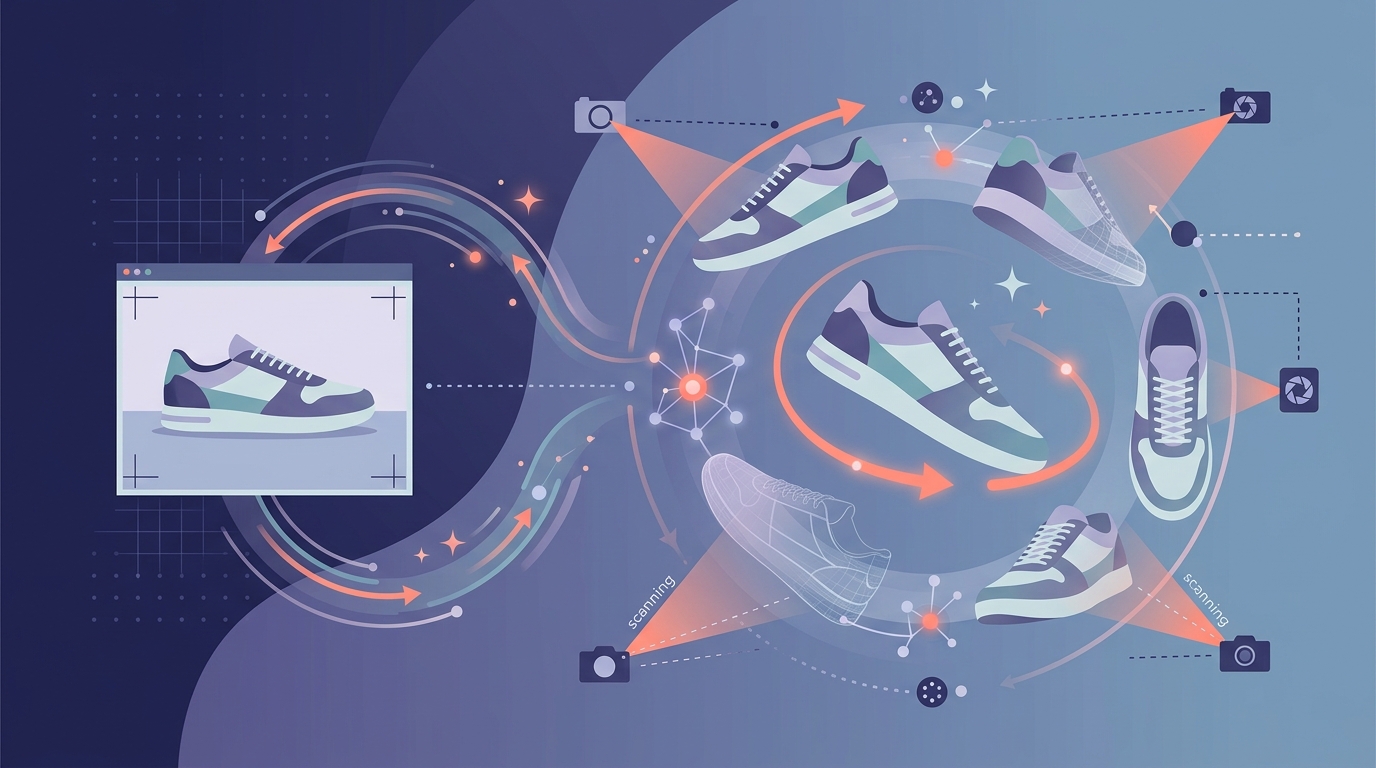
Ik stuitte op een bericht van AI-onderzoeker Abubakar Abid (@_akhaliq) over een nieuw open-source model: de Qwen-Image-2.1-Multiple-Angles-LoRA. Het idee is simpel maar krachtig: je voert één foto in, geeft aan vanuit welke hoek je het object wilt zien, en het model genereert die nieuwe weergave. Ik vind dat interessant genoeg om er even bij stil te staan, want dit raakt direct aan iets waar veel ondernemers geld aan uitgeven: productfotografie.
Wat doet dit model precies?
De Qwen-Image-2.1-Multiple-Angles-LoRA is een zogenaamde LoRA-adapter — een kleine toevoeging bovenop een groter AI-model (in dit geval Qwen-Image-2.1 van het Chinese Alibaba). Denk aan een LoRA als een specialistisch brilletje dat je op een bestaand model zet: het basismodel kan al beelden genereren en bewerken, en dit brilletje leert het specifiek om camerahoeken te veranderen.
Concreet ondersteunt het model:
- 12 horizontale draaihoeken (azimut), in stappen van 30 graden — van recht vooraan tot recht achter en alles ertussen.
- 4 verticale kijkhoogtes (elevatie) — ooghoogte, licht verhoogd (30°), steil (60°) en recht van boven (90°).
- Een close-up variant van elke combinatie.
Dat levert in totaal 72 adresseerbare cameraposities op. Je typt een prompt met het trigger-woord <mva>, beschrijft de gewenste hoek (bijvoorbeeld "front-right, elevated"), en het model probeert diezelfde stoel, vaas of sneaker vanuit die hoek te tonen.
Hoe is het getraind?
Volgens de modelkaart op Hugging Face is versie 2 getraind op 13.328 beeldparen, afkomstig uit 3D-datasets zoals Objaverse — een grote verzameling driedimensionale objecten. Het model heeft dus geleerd hoe objecten eruitzien vanuit verschillende hoeken door naar gerenderde 3D-modellen te kijken. De licentie is Apache 2.0, wat betekent dat het vrij te gebruiken is, ook commercieel.
Waarom is dit relevant voor productfotografie?
Als je een webshop runt of producten online verkoopt, weet je dat foto's vanuit meerdere hoeken de standaard zijn. Klanten willen een product van voren, van opzij, van boven en soms van achteren zien. Traditioneel betekent dat: een fotograaf inhuren, een studio boeken, elk product op een draaitafel zetten en tientallen foto's maken.
De kosten lopen op. Volgens recente analyses kost traditionele productfotografie gemiddeld 90 tot 270 dollar per SKU. Bij een assortiment van honderden producten praat je al snel over duizenden euro's. AI-gestuurde alternatieven brengen dat terug naar een fractie — schattingen lopen uiteen van 3 tot 13 dollar per afbeelding.
Wat mij opvalt aan dit specifieke model: het is volledig open-source en gratis beschikbaar. Je hebt geen abonnement nodig bij een SaaS-platform. Wel heb je technische kennis nodig om het te draaien — dit is geen klik-en-klaar oplossing. Maar het signaal is duidelijk: de technologie om vanuit één foto meerdere hoeken te genereren wordt steeds toegankelijker.
Wat kan het wel en wat (nog) niet?
Ik wil eerlijk zijn over de beperkingen, want een blogpost die alleen de beloftes opsomt helpt niemand.
Wat goed werkt
Het model presteert het best op objecten die lijken op wat het heeft gezien tijdens training: harde oppervlakken, duidelijke vormen, producten met weinig transparante of reflecterende materialen. Denk aan meubels, schoenen, verpakkingen, keramiek.
Waar het minder goed werkt
De modelkaart vermeldt expliciet dat fijn detail — zoals dierenvacht — zachter wordt bij onderwerpen die sterk afwijken van de trainingsdata. Dat is logisch: het model heeft 3D-renders gezien, geen echte foto's van pluizige katten. Ook complexe producten met veel kleine onderdelen of ongebruikelijke materialen zullen waarschijnlijk minder nauwkeurig worden weergegeven.
Een ander punt: de gegenereerde beelden zijn AI-output, geen echte foto's. Voor een webshop waar klanten verwachten dat ze het échte product zien, kan dat een probleem zijn — zeker als de AI subtiele details anders interpreteert dan de werkelijkheid. Ik zou zelf willen weten hoe consistent het model is bij herhaalde generaties van hetzelfde product.
Wat betekent dit praktisch voor een ondernemer?
Stel dat je als ondernemer een webshop hebt met 500 producten. Je wilt van elk product vijf hoeken. Dat zijn 2.500 foto's. Met traditionele fotografie ben je daar weken mee bezig en kwijt je duizenden euro's. Met een model als dit zou je — in theorie — met 500 basisfoto's kunnen werken.
Maar er zit een "maar" aan. Je hebt nu nog technische kennis nodig om dit te gebruiken. Je moet het model lokaal draaien of via een cloud-GPU laten werken. Je hebt software nodig zoals ComfyUI om de LoRA in te laden. En je moet de output handmatig controleren op kwaliteit.
Voor de gemiddelde MKB-ondernemer is dit dus nog geen plug-and-play oplossing. Maar wat ik wel zie: dit soort modellen wordt snel opgepikt door platforms en tools die er wél een gebruiksvriendelijke interface omheen bouwen. De kans is groot dat je binnen afzienbare tijd bij bestaande productfotografie-diensten een knop "genereer extra hoeken" ziet verschijnen — aangedreven door precies dit soort technologie.
De bredere trend: van fotostudio naar AI-pipeline
Dit model staat niet op zichzelf. In dezelfde periode verschenen er meer LoRA-adapters voor Qwen-Image-2.1: eentje voor anime-consistentie en eentje om illustraties om te zetten naar realistische beelden. Het laat zien dat de open-source gemeenschap snel specialistische functies toevoegt aan basismodellen.
Wat mij betreft is de trend helder: productfotografie verschuift van een puur fysiek proces naar een hybride aanpak. Eén goede basisfoto — liefst met goede belichting en een neutraal achtergrond — wordt het startpunt. AI doet de rest: extra hoeken, achtergrondvariaties, lifestyle-scènes.
Dat betekent niet dat fotografen overbodig worden. Integendeel: de basisfoto moet goed zijn, anders werkt de AI niet. Maar het volume-werk — diezelfde stoel vanuit zes hoeken vastleggen — dat kan steeds vaker digitaal.
Tot slot
Voor mij is dit vooral een signaal dat de drempel voor hoogwaardige productvisualisatie verder daalt. Niet morgen, niet voor iedereen, en niet zonder kanttekeningen bij kwaliteit. Maar de richting is onmiskenbaar. Als je nu veel uitgeeft aan productfotografie, is het slim om deze ontwikkelingen in de gaten te houden — niet om er vandaag op over te stappen, maar om te weten wanneer het moment daar is.
80% van de AI-projecten haalt productie nooit.
Ik bouw de 20% — van prototype naar draaiend systeem, binnen weken.